
Culture · IA responsable
Que révèle la numérisation de livres pour l’IA ?
L’affaire Anthropic pose des questions sur l’accès au savoir et l’origine des données.
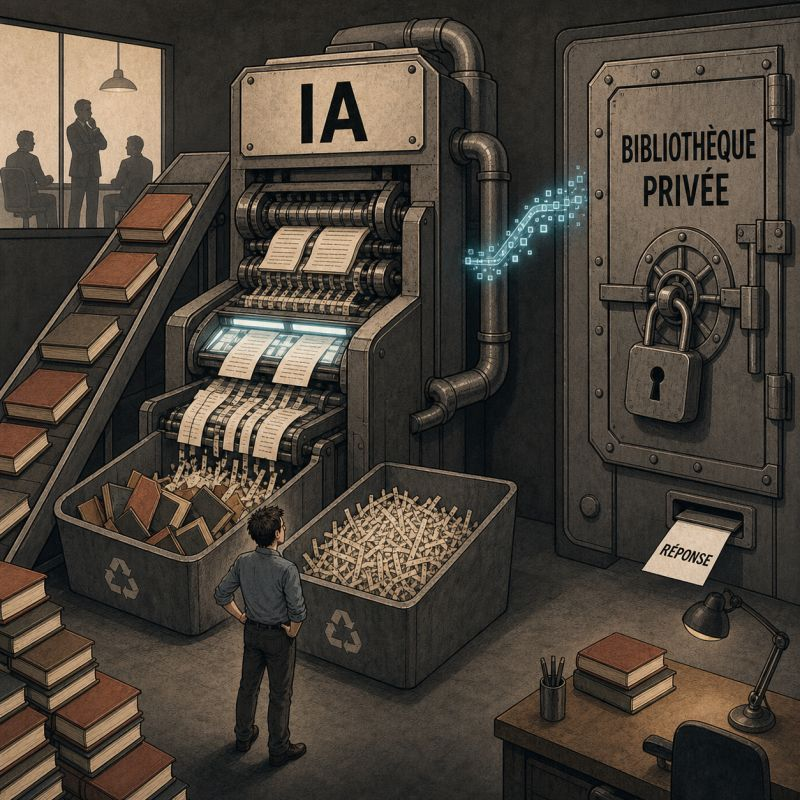
Que sommes-nous prêts à sacrifier pour rendre l’IA plus intelligente ?
Pour constituer une vaste bibliothèque de recherche, Anthropic a acheté des millions de livres papier, souvent d’occasion.
Les reliures ont été retirées, les pages découpées, les ouvrages numérisés puis les exemplaires physiques ont été jetés.
Une partie de cette bibliothèque a ensuite été utilisée pour entraîner les modèles à l’origine de Claude.
Le plus troublant ?
La destruction des originaux a contribué à rendre l’opération juridiquement défendable : un exemplaire physique acheté était remplacé par une copie numérique interne, sans être diffusé au public.
La justice américaine a donc considéré cette numérisation, ainsi que l’entraînement à partir de livres acquis légalement, comme relevant du « fair use ».
En parallèle, l’acquisition de millions de copies piratées a conduit Anthropic à un accord collectif de 1,5 milliard de dollars, approuvé définitivement par le tribunal le 20 juillet 2026.
Bin… ce n’est pas la première fois qu’une nouvelle technologie sacrifie l’ancien support du savoir.
- Après l’apparition de l’imprimerie, des manuscrits devenus obsolètes ont été découpés et recyclés pour fabriquer les reliures des nouveaux livres.
- Au XXᵉ siècle, des bibliothèques ont microfilmé des journaux et des ouvrages fragiles avant de jeter les originaux, au nom de leur préservation.
- Plus récemment, Google Books a numérisé des millions de livres pour les rendre consultables et recherchables en ligne.
À chaque révolution, une partie du support précédent semble devenir une matière première pour le suivant.
Mais dans le cas de l’IA, quelque chose change.
Le livre physique disparaît, tandis que sa copie numérique peut rester enfermée dans une bibliothèque privée, inaccessible gratuitement au public.
La copie numérique peut rester dans une bibliothèque privée, tandis que son contenu contribue à l’entraînement de modèles accessibles via des services commerciaux. La décision de justice distingue cette numérisation de l’acquisition de copies piratées.
Précision importante : rien ne permet d’affirmer que des exemplaires uniques ont été détruits. Mais l’échelle et la destination de cette numérisation méritent déjà d’être interrogées.
- Qui décide de ce qui peut être sacrifié ?
- Quelle traçabilité conservons-nous sur les connaissances utilisées ?
- Qui bénéficie finalement de la valeur créée ?
🎯 L’IA responsable ne commence pas au moment où nous écrivons un prompt. Elle commence bien avant : dans la manière dont les données, les œuvres et les connaissances ont été acquises.
Sources
- Décision du 23 juin 2025 sur le fair use, Bartz v. Anthropic (PDF)
- Ordonnance du 20 juillet 2026 approuvant l’accord collectif
Pour aller plus loin sur le choix des usages et l’origine des données, découvrez mon approche de l’IA responsable.